Was wäre, wenn Wissenschaftler Millionen von DNA-Fragmenten gleichzeitig untersuchen, bisher unentdeckte genetische Varianten identifizieren und molekulare Mechanismen aufdecken könnten, die in komplexen biologischen Systemen verborgen sind?
Genau das ermöglicht das Next-Generation-Sequencing (NGS). Durch die Hochdurchsatzanalyse von DNA und RNA hat NGS die Erforschung von Genomen, die Untersuchung der Genexpression, die Charakterisierung von Mikroorganismen und die Analyse der molekularen Ursachen von Krankheiten grundlegend verändert.
Doch die nächste Entwicklungsstufe der Sequenzierung besteht nicht nur darin, immer mehr genetische Daten zu erzeugen. Entscheidend ist vielmehr, Sequenzinformationen mit biologischen Funktionen, computergestützten Analysemethoden und aussagekräftigen wissenschaftlichen Erkenntnissen zu verknüpfen.
Mit der Weiterentwicklung der Sequenziertechnologien eröffnen die Integration von Long-Read-Sequenzierung, Einzelzellanalyse, Multi-Omics und künstlicher Intelligenz neue Möglichkeiten für die biowissenschaftliche Forschung.
1. Von DNA-Fragmenten zu biologischen Erkenntnissen
Die klassische Sanger-Sequenzierung ist weiterhin für gezielte DNA-Analysen geeignet. NGS ermöglicht hingegen die parallele Untersuchung von Millionen DNA-Fragmenten und unterstützt damit groß angelegte Forschungsprojekte, die mit herkömmlichen Methoden deutlich schwieriger umzusetzen wären.

Ein typischer NGS-Workflow umfasst mehrere miteinander verbundene Schritte:
Probenvorbereitung: DNA oder RNA wird extrahiert und hinsichtlich ihrer Qualität und Menge überprüft.
Bibliothekspräparation: Die Nukleinsäuren werden aufbereitet und mit Sequenzieradaptern versehen.
Sequenzierung: Eine Sequenzierplattform erzeugt Reads, die die untersuchten Nukleinsäuremoleküle repräsentieren.
Bioinformatische Verarbeitung: Die Rohdaten werden einer Qualitätskontrolle unterzogen, ausgerichtet oder assembliert und computergestützt analysiert.
Biologische Interpretation: Forschende identifizieren relevante Varianten, Expressionsmuster, mikrobielle Profile und andere molekulare Merkmale.
Jeder dieser Schritte beeinflusst die Zuverlässigkeit der Ergebnisse. Eine unzureichende Probenqualität, eine zu geringe Sequenziertiefe, Kontaminationen oder ungeeignete Analyseparameter können die Schlussfolgerungen verfälschen.
Die zentrale Herausforderung besteht daher nicht einfach darin, mehr Moleküle zu sequenzieren, sondern verlässliche Daten zu erzeugen, mit denen sich eine klar definierte biologische Fragestellung beantworten lässt.

2. Short Reads, Long Reads und die neue Sequenzierungslandschaft
NGS bezeichnet keine einzelne Technologie. Unterschiedliche Sequenzierungsverfahren bieten jeweils spezifische Vorteile, abhängig von der biologischen Fragestellung und den Eigenschaften der untersuchten Probe.
Short-Read-Sequenzierung
Short-Read-Plattformen, darunter Systeme von Illumina, erzeugen große Mengen relativ kurzer DNA-Sequenzen. Sie werden häufig für die Gesamtgenomsequenzierung, gezielte Genpanels, RNA-Sequenzierung und zahlreiche weitere Anwendungen eingesetzt.
Ihr hoher Durchsatz und etablierte Analyseverfahren machen sie besonders nützlich für Untersuchungen, bei denen einzelne Basen in umfangreichen Datensätzen präzise charakterisiert werden müssen.
Allerdings kann die Zuordnung kurzer Reads in repetitiven Genomregionen schwierig sein. Auch die Rekonstruktion komplexer struktureller Varianten stellt eine Herausforderung dar.
Long-Read-Sequenzierung
Technologien von Pacific Biosciences und Oxford Nanopore Technologies ermöglichen die Erzeugung deutlich längerer Reads. Dadurch können Forschende Genomregionen untersuchen, die mit Short-Read-Verfahren nur schwer zu charakterisieren sind.
Die Long-Read-Sequenzierung unterstützt unter anderem:
Die Erkennung komplexer struktureller Varianten.
Die Analyse repetitiver DNA-Regionen.
Die Charakterisierung vollständiger RNA-Transkripte und alternativer Spleißvarianten.
Die Haplotyp-Phasierung, mit der sich feststellen lässt, welche genetischen Varianten gemeinsam auf einem Chromosom vorkommen.
Die Untersuchung bestimmter DNA-Modifikationen, abhängig von der Plattform und der verwendeten Analysemethode.
Diese Möglichkeiten sind besonders bei komplexen Genomen und bislang ungeklärten genetischen Fragestellungen relevant. Neuere Forschungsarbeiten zeigen, dass Long-Read-Gesamtgenomanalysen genetische Variationen aufdecken können, die mit herkömmlichen Verfahren möglicherweise übersehen werden.
Welche Technologie am besten geeignet ist, hängt von der benötigten Auflösung, den Probeneigenschaften, den Analysezielen und den verfügbaren Ressourcen ab.
3. RNA-Sequenzierung: Die Aktivität von Genen verstehen
Das Genom enthält den genetischen Bauplan eines Organismus. Es zeigt jedoch nicht vollständig, welche Gene zu einem bestimmten Zeitpunkt aktiv sind und wie sich ihre Aktivität unter verschiedenen Bedingungen verändert.
Die RNA-Sequenzierung (RNA-seq) untersucht die in einer Probe vorhandenen RNA-Moleküle. Dadurch können Forschende bestimmen, welche Gene exprimiert werden, wie sich ihre Expression zwischen experimentellen Bedingungen verändert und welche Transkriptvarianten vorkommen.
RNA-seq ermöglicht unter anderem die Untersuchung von:
Unterschieden in der Genexpression zwischen gesundem und erkranktem Gewebe.
Zellulären Reaktionen auf Umweltstress oder experimentelle Behandlungen.
Alternativem Spleißen und der Vielfalt von Transkripten.
Molekularen Signalwegen, die mit dem Fortschreiten von Krankheiten verbunden sind.
Potenziellen Biomarkern für weiterführende Untersuchungen.
Ein Beispiel ist die Erforschung von oxidativem Stress. Forschende könnten RNA-seq-Profile unbehandelter Zellen mit denen von Zellen vergleichen, die einem oxidativen Reiz ausgesetzt wurden, sowie mit Zellen, die zusätzlich eine schützende Behandlung erhalten haben.
Die resultierenden Daten können Gene und Signalwege identifizieren, die mit zellulären Stressreaktionen, Entzündungsprozessen oder antioxidativen Schutzmechanismen verbunden sind.
Veränderungen der RNA-Menge belegen jedoch nicht automatisch Veränderungen der Proteinmenge oder der biologischen Aktivität. Transkriptomische Ergebnisse sollten deshalb möglichst gemeinsam mit weiteren experimentellen Daten interpretiert werden.

4. Einzelzellsequenzierung: Mehr als durchschnittliche Genexpression
Bei der Bulk-Sequenzierung werden molekulare Informationen aus vielen Zellen zusammengefasst. Das liefert einen umfassenden Überblick, kann jedoch Unterschiede zwischen einzelnen Zellpopulationen verdecken.
Die Einzelzellsequenzierung eröffnet eine andere Perspektive, indem sie molekulare Eigenschaften auf Ebene einzelner Zellen untersucht.

Mit der Einzelzell-RNA-Sequenzierung können Forschende unterschiedliche Zellpopulationen identifizieren, zelluläre Zustände charakterisieren und untersuchen, wie verschiedene Zellen auf denselben biologischen Reiz reagieren.
Diese Methode ist besonders relevant für die Untersuchung heterogener Gewebe, Immunreaktionen, der Tumormikroumgebung und biologischer Entwicklungsprozesse.
Stellen wir uns eine Tumorprobe vor, die mehrere unterschiedliche Zellpopulationen enthält. Eine Bulk-RNA-Sequenzierung könnte ein allgemeines Expressionsmuster aufzeigen. Eine Einzelzellanalyse könnte dagegen helfen, Tumorzellen von Immunzellen und stromalen Zellpopulationen zu unterscheiden.
Diese höhere Auflösung ermöglicht es, Zelluntergruppen zu entdecken, die andernfalls möglicherweise unentdeckt blieben.
Allerdings bringt die Einzelzellsequenzierung eigene Herausforderungen mit sich, darunter technisches Rauschen, eine variable Erfassung von Transkripten, hohe Anforderungen an die Rechenleistung und die Notwendigkeit einer sorgfältigen Versuchsplanung.
5. Wenn NGS auf künstliche Intelligenz trifft
Eine der spannendsten Entwicklungen in der modernen Genomik ist die Verbindung von Sequenzierungsdaten mit künstlicher Intelligenz.
NGS erzeugt enorme Datenmengen. Um darin aussagekräftige biologische Muster zu erkennen, sind jedoch leistungsfähige computergestützte Analysemethoden erforderlich.
Maschinelles Lernen und Deep Learning können verschiedene Aufgaben unterstützen:
Priorisierung genetischer Varianten: Computermodelle können genetische Varianten nach ihrer potenziellen Relevanz für eine Forschungsfrage priorisieren.
Mustererkennung: KI kann komplexe Zusammenhänge zwischen Sequenzmerkmalen und biologischen Eigenschaften identifizieren.
Analyse der Genexpression: Vorhersagemodelle können helfen, Beziehungen zwischen Genexpression, zellulären Zuständen und experimentellen Bedingungen zu untersuchen.
Biomarkerentdeckung: Computergestützte Ansätze können potenzielle molekulare Signaturen identifizieren, die anschließend experimentell überprüft werden müssen.
Multi-Omics-Integration: KI kann genomische, transkriptomische, proteomische und weitere molekulare Datensätze zusammenführen, um biologische Systeme aus unterschiedlichen Perspektiven zu untersuchen.

Diese Methoden entwickeln sich schnell weiter. Dennoch sind KI-Vorhersagen kein Ersatz für experimentelle Belege. Die Leistungsfähigkeit eines Modells hängt von der Datenqualität, dem Trainingsdesign, der externen Validierung und dem biologischen Kontext ab.
Besonders wertvoll sind Systeme, die effiziente Berechnungen mit nachvollziehbaren Ergebnissen und einer unabhängigen biologischen Validierung verbinden.
6. Die verborgene Herausforderung: Aus Sequenzierungsdaten verlässliche Ergebnisse gewinnen
Trotz seiner großen Möglichkeiten bringt NGS wichtige analytische und praktische Herausforderungen mit sich.
Datenvolumen: Umfangreiche Sequenzierungsprojekte erfordern erhebliche Rechenkapazitäten und ein effizientes Datenmanagement.
Datenqualität: Sequenzierungsfehler, Kontaminationen, Probenabbau und eine ungleichmäßige Abdeckung können die nachfolgenden Analysen beeinflussen.
Referenzbias: Die Ausrichtung von Reads auf ein Referenzgenom kann die Interpretation bestimmter genetischer Variationen erschweren, insbesondere in repetitiven oder stark variablen Regionen.
Interpretation genetischer Varianten: Der Nachweis einer genetischen Veränderung belegt nicht automatisch ihre biologische Bedeutung oder klinische Relevanz.
Reproduzierbarkeit: Unterschiede bei Software, Referenzdatenbanken, Analyseparametern und Qualitätskontrollverfahren können zu abweichenden Ergebnissen führen.
Ethische Aspekte: Menschliche Genomdaten können sensible Informationen enthalten. Datenschutz, informierte Einwilligung und eine verantwortungsvolle Datenverwaltung sind daher unverzichtbar.
Die Bewältigung dieser Herausforderungen erfordert die Zusammenarbeit von Molekularbiologen, Bioinformatikern, Statistikern, Medizinern und weiteren Fachleuten.
Die Qualität einer Sequenzierungsstudie wird nicht allein durch die Menge der erzeugten Daten bestimmt. Entscheidend ist die Fähigkeit, reproduzierbare Ergebnisse zu gewinnen und verantwortungsvoll zu interpretieren.
7. Wie geht es weiter? Die Zukunft der Sequenzierung ab 2026
Die nächste Entwicklungsphase der Sequenzierungsforschung wird voraussichtlich von mehreren sich ergänzenden Innovationen geprägt sein.
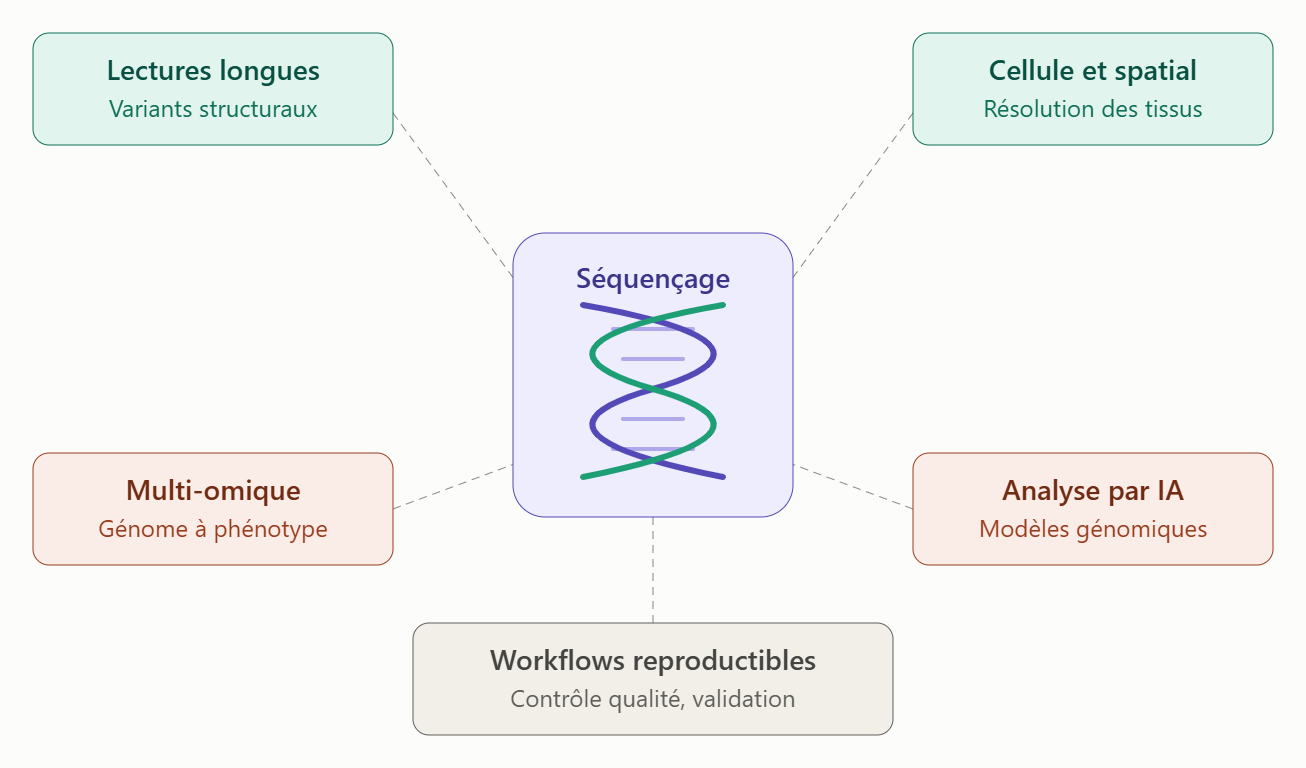
Umfassendere Long-Read-Analysen: Verbesserte computergestützte Methoden erweitern die Möglichkeiten zur Untersuchung komplexer Genomregionen, struktureller Variationen und von Haplotypen.
Einzelzell- und räumliche Analyseverfahren: Forschende untersuchen molekulare Aktivitäten zunehmend auf der Ebene einzelner Zellen und können bei räumlichen Methoden zusätzlich deren Position und Organisation innerhalb eines Gewebes berücksichtigen.
KI-gestützte Interpretation: Maschinelles Lernen und neue genomische Foundation-Modelle eröffnen zusätzliche Möglichkeiten für die Sequenzanalyse, die Interpretation genetischer Varianten und die Integration biologischer Datensätze.
Integrierte molekulare Forschung: Multi-Omics-Ansätze verbinden genomische Informationen mit Genexpression, Proteinaktivität und zellulären Phänotypen.
Reproduzierbare Analyse-Workflows: Standardisierte Analysepipelines, transparente Qualitätskontrollen und eine robuste Validierung bleiben unverzichtbar, wenn Sequenzierung zunehmend in Forschungs- und klinische Prozesse integriert wird.
Diese Entwicklungen ersetzen weder die experimentelle Validierung noch die fachkundige Interpretation. Sie erweitern vielmehr das Spektrum biologischer Fragestellungen, die Forschende untersuchen können.
Die Zukunft der Genomik wird davon abhängen, immer leistungsfähigere Technologien mit rigoroser wissenschaftlicher Methodik zu verbinden.
Die Sequenzierung ist erst der Anfang
Das Next-Generation-Sequencing hat die Art und Weise verändert, wie Wissenschaftler biologische Informationen untersuchen. Es ermöglicht groß angelegte Genomanalysen, unterstützt die Erforschung der Genexpression und eröffnet neue Wege zur Untersuchung genetischer Variationen und biologischer Komplexität.
Die bedeutendsten Fortschritte entstehen jedoch dann, wenn Sequenzierungsdaten in einen umfassenderen wissenschaftlichen Prozess eingebettet werden: sorgfältig geplante Experimente, zuverlässige Bioinformatik, fundierte Interpretation und unabhängige Validierung.
Während sich Long-Read-Sequenzierung, Einzelzelltechnologien, Multi-Omics und künstliche Intelligenz weiterentwickeln, wird NGS ein wesentlicher Bestandteil der modernen biologischen Forschung bleiben.
Die eigentliche Chance besteht nicht nur darin, mehr DNA zu lesen, sondern die Biologie besser zu verstehen.